속보08 / 업계
Rubin HBM 약 3% 증가, 달러당 처리량 최대 30배
 권태오· 업계
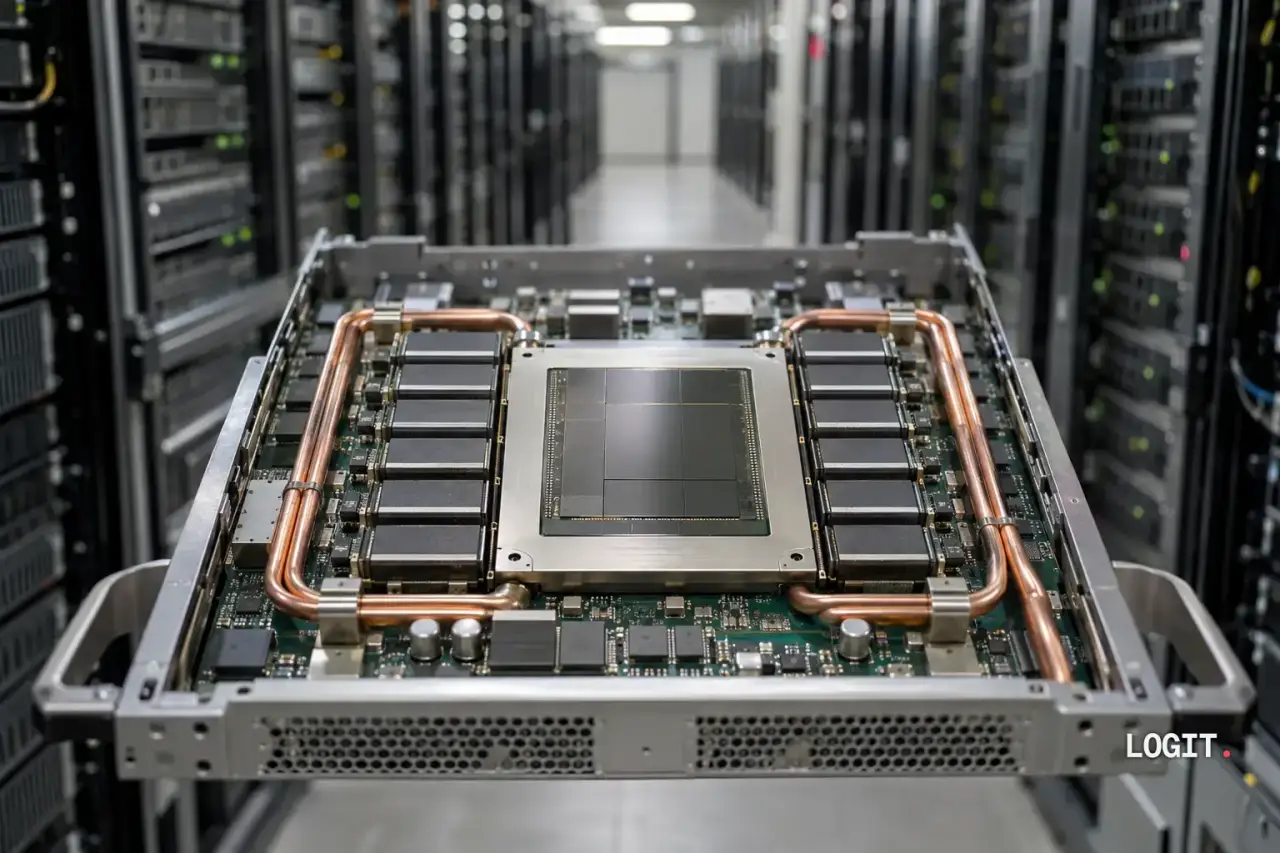
NVIDIA는 11월 6일 최대 72개 GPU를 묶는 Vera Rubin NVL72의 GPU당 고대역폭 메모리(HBM) 용량이 이전 세대보다 약 3% 늘었다고 밝혔다. 달러당 에이전트 처리량은 같은 세대 비교에서 최대 30배 늘었다고 덧붙였다.
30배는 SemiAnalysis AgentX의 DeepSeek V4 Pro 작업에서 사용자당 초당 125토큰 조건을 적용한 값으로 NVIDIA 블로그에 적혀 있다. 비교 상대는 Blackwell Ultra 세대의 GB300 NVL72였다. GB300 NVL72는 사용자당 초당 100토큰 조건에서 H200 플랫폼보다 달러당 처리량이 최대 10배 높았고, GPU당 HBM은 대체로 두 배로 늘었다.
메모리 벽. NVIDIA는 HBM을 더 얹어도 대역폭이 연산 속도를 따라가지 못하는 지점을 메모리 벽으로 설명했다. 이 한계를 넘으면 늘린 용량은 쓰이지 못한 채 비용과 전력만 더한다고 덧붙였다. 운영자가 볼 지표로는 전력 예산과 응답 시간 안에서 내보내는 유효 토큰 수를 제시했다.
HBM 절감. NVIDIA에 따르면 4비트 정밀도 형식 NVFP4는 모델 가중치와 KV 캐시(요청별 맥락을 담는 작업 메모리)의 크기를 FP8보다 줄였다. NVL72에서는 가중치를 최대 72개 GPU에 나눠 담아 GPU마다 남는 HBM을 늘렸다. 쓰지 않는 맥락은 추론 소프트웨어 Dynamo가 저장 계층 CMX로 옮겼다가 재사용 전에 되돌리도록 했다.
메모리 공급이 빠듯해지고 가격이 오르는 흐름은 당분간 이어질 것으로 예상된다고 NVIDIA는 밝혔다. 회사는 HBM3e와 HBM4를 가속 컴퓨팅 스택에 가장 먼저 도입했다고 덧붙였다. Cloudian, DDN, Dell Technologies, Everpure, HPE, IBM, NetApp, VAST, WEKA는 CMX 협력사로 블로그에 적혀 있다.
NVIDIA는 최대 30배 산정에 쓴 시스템 단가와 HBM 수율을 블로그에서 공개하지 않았다.