속보08 / 업계
예진, H200 8장으로 학습한 한국어 8B 모델 공개
공식 기술 문서와 모델 카드의 매개변수 수가 서로 달라 8B 표기의 실제 규모는 설명이 필요하다.
 권태오· 업계
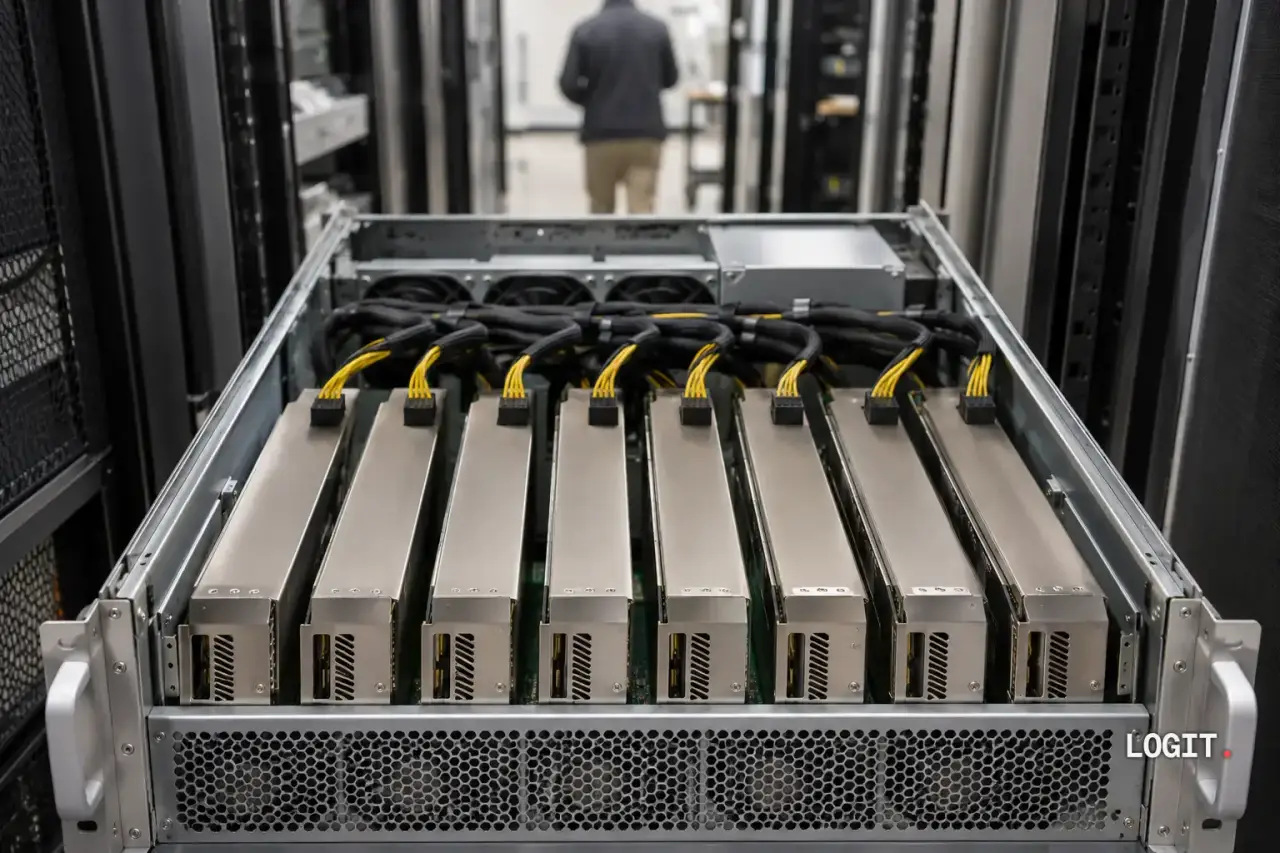
AI타임스에 따르면 예진은 11월 6일 엔비디아 H200 8장으로 학습한 약 15GB 규모의 예진 8B v3를 개발했다고 밝혔고, 장비는 정부 사업에서 받았다.
매개변수. AI타임스는 이 모델을 80억 매개변수로 전했지만, 모델 카드 제원에는 약 75.2억 개가 적혀 있다. 공식 기술 문서의 값은 약 72.4억 개로, 회사 문서끼리도 수치가 다르다.
모델 카드에 따르면 모델은 32개 층과 은닉 크기 4096으로 구성됐고, 어휘는 64,000개, 입력 한도는 4096토큰이다. 기술 문서는 원천 데이터 약 2.7TB와 기초 839억·전문지식 545억, 합계 1,384억 토큰의 학습량을 공개했다.
회사 기술 문서는 모델이 "무작위 초기 가중치에서 출발해" 토크나이저 설계부터 학습까지 수행했다고 적었다. 회사는 공개 모델 6종과 견준 가중치 코사인 유사도(두 값이 닮은 정도)가 0.0014 이하라고 밝혔다. 모델 카드 태그에는 qwen3-architecture가 표기돼 있고, 회사 문서가 독자 수행 범위로 든 것은 가중치와 토크나이저, 학습이다.
공개 조건. 모델 카드에 따르면 가중치는 Apache 2.0 라이선스로 공개됐고, 지시 정렬을 거치지 않은 base 모델이다. 대화 기능은 후속 정렬 모델에서 제공한다고 회사는 예고했다. 기술 문서의 K-AI 평균점수 0.366은 공개 base 모델이 아니라 v3 기반 대화형 사후학습 모델의 결과다.
AI타임스에 따르면 학습에 쓴 엔비디아 H200 그래픽처리장치(GPU)는 과학기술정보통신부와 정보통신산업진흥원(NIPA)의 고성능 컴퓨팅 지원사업으로 받았다. 회사 사이트는 국내 기업·공공기관 맞춤 구축을 안내하며, 비용은 상담 후 견적으로 제시한다고 설명했다.
회사는 문서마다 매개변수 수가 다른 이유와 가중치 유사도의 상세 실험 자료를 공개하지 않았다.