01 / AI · 분석
MINE 연구진, RTX 4060 Ti 추론 2.52배 가속
연구진 공개 수치는 Llama 3.1 8B Instruct의 2.1비트 EntQuant 체크포인트 결과이고, RTX 5090에서는 1.48배였다.
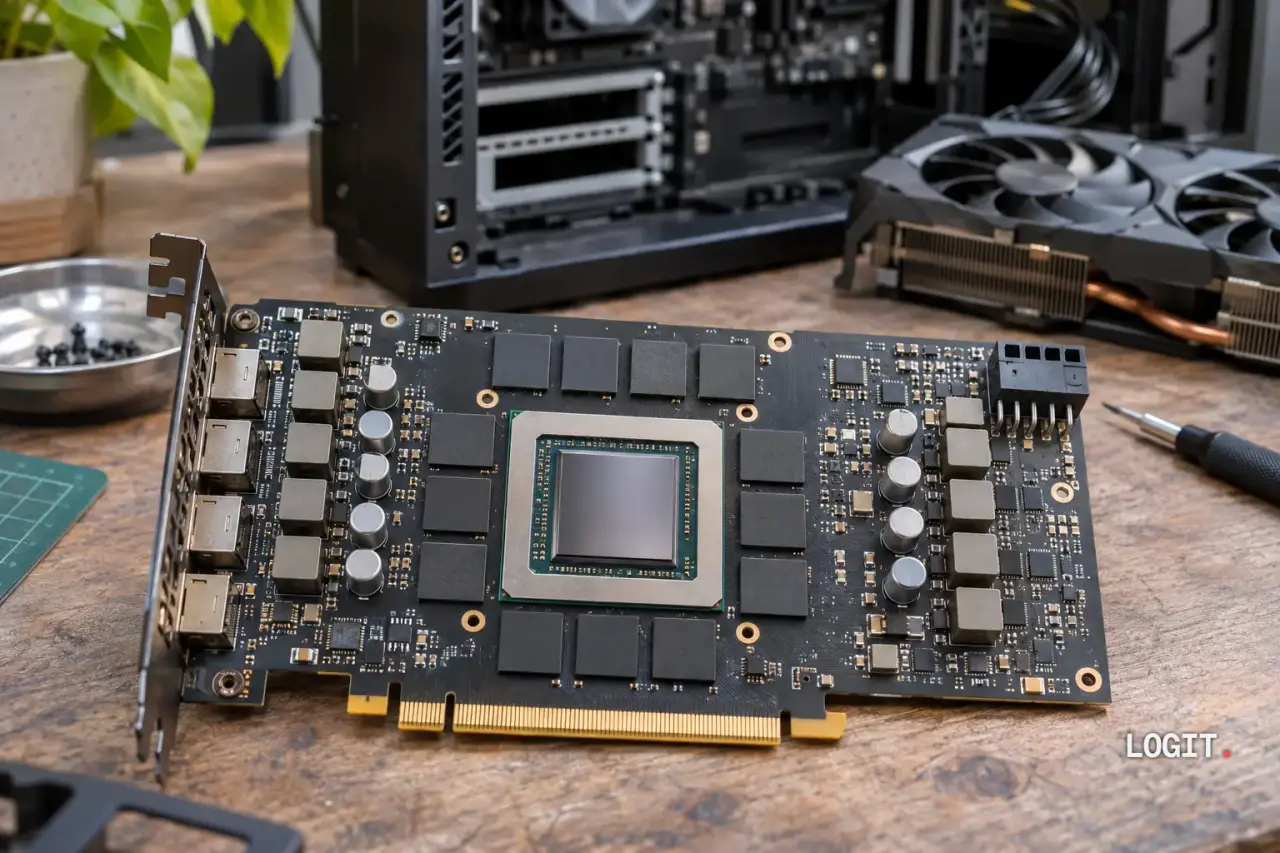
MINE 연구진은 Llama 3.1 8B 추론 2.52배 가속을 RTX 4060 Ti에서 달성했다고 발표했다. RTX 5090에서는 1.48배였고, 비교 대상은 가장 빠른 기준 방식이다(연구진 공개 수치). 논문은 11월 9일 arXiv에 실렸고, 저자들은 MINE이 오픈소스라고 밝혔다.
연구진이 겨냥한 환경은 요청을 묶어 처리할 수 없는 로컬·저지연 추론이다. 논문에 따르면 이 환경은 토큰 하나를 만들 때마다 모든 가중치(모델이 학습한 수치)를 메모리에서 읽는 구조다. 속도의 병목이 메모리인 이유다.
MINE 논문이 보고한 가속 폭은 실행 조건에 따라 달랐다. 같은 날 arXiv에 실린 글쓰기 평가 논문도 평가자에 따라 결과가 갈렸다고 보고했다. 두 수치 모두 조건과 함께 읽어야 하는 값이다.
GPU별 MINE 추론 가속 배수(연구진 공개 수치)
| RTX 4060 Ti | 2.52 | |
|---|---|---|
| RTX 5090 | 1.48 |
가중치 분포를 이용한 GPU 압축
논문은 MINE을 "a lossless entropy coding approach"로 규정했다. 자주 나오는 값을 짧게 적어 손실 없이 크기를 줄이는 압축이라는 뜻이다. 핵심인 dtANS-LLM은 기존 dtANS를 LLM 추론에 맞게 고친 GPU용 방식이다.
연구진은 양자화 뒤에도 가중치 값의 분포가 고르지 않다는 점을 이용했다. 양자화는 가중치를 더 적은 비트로 줄이는 처리다. 압축률과 복호화 비용은 조정 변수로 맞바꾸도록 설계했다.
논문에 따르면 MINE은 이 변수를 텐서와 GPU마다 자동 조정해 파레토 프런트를 구했다. 파레토 프런트는 모델 크기와 복호화 지연이 맞물린 최적 조합의 경계다. vLLM에는 플러그인으로 통합됐고, 주어진 메모리 예산에 맞는 커널 설정을 고르는 방식이다.
GPU별로 달라진 가속 폭
실험은 Llama 3.1 8B Instruct의 2.1비트 EntQuant 체크포인트로 진행됐다고 논문은 밝혔다. RTX 4060 Ti의 유효 비트레이트(가중치 하나에 실제로 드는 비트 수)는 2.24비트였다(연구진 공개 수치). RTX 5090에서는 3.43비트였다(연구진 공개 수치).
연구진은 기존 무손실 압축의 속도 향상이 BF16 같은 특정 데이터 형식과 추가 가정에 한정됐다고 지적했다. 비교 기준은 초록에 가장 빠른 기준 방식(fastest baseline)으로만 적혀 있고, 그 방식의 이름과 종류는 초록에 없다.
글쓰기 평가가 보여 준 평가자 차이
같은 날 arXiv에 실린 다른 논문은 추론 강화 모델이 단편소설의 심리적 깊이도 높이는지 검증했다. 비교쌍은 DeepSeek-R1과 DeepSeek-V3, GPT-5와 GPT-4o였다. 논문에 따르면 사람 평가자 일곱 명과 LLM 심판 앙상블이 모델 이름을 가린 일대일 비교 60건을 맡았다.
논문에 따르면 사람 평가에서 GPT-5의 선호율은 GPT-4o 대비 60.0-62.9%였다(연구진 공개 수치). 범위는 추론 강도 설정 두 가지의 결과다. DeepSeek-R1은 DeepSeek-V3 대비 42.9%로 뒤졌다(연구진 공개 수치).
평가자 간 일치도 지표인 크리펜도르프 알파는 0.070으로 낮았다(연구진 공개 수치). 저자들은 이를 평가 실패가 아니라 실제 주관 차이로 해석했다.
논문에 따르면 LLM 심판은 추론 모델을 98.3%의 쌍에서 택해, 사람 투표의 55.2%보다 크게 기울었다(연구진 공개 수치). 논문은 이 편향이 다섯 가지 구성에서 일관됐고 문장 길이와 일부 연동됐다고 밝혔다.
조건을 떼면 읽히지 않는 수치
글쓰기 논문 저자들은 최전선 모델의 추론 관련 품질 차이가 작다는 점을 결과가 시사한다고 썼다. 그 차이는 "dominated by reader subjectivity"될 만큼 작다는 설명이다. 독자의 주관에 좌우될 정도라는 뜻이다. 저자들은 LLM 심판이 이런 주관 차이를 가릴 수 있다고 썼다.
MINE 초록의 가속 수치도 모델 하나와 GPU 두 종의 결과다. 속도 배수와 선호율은 조건을 함께 적어야 읽히는 값이다. 다른 LLM에서 MINE이 낸 가속 수치는 논문 초록에 없다.