AI
언어모델과 영상·이미지·음성 생성 AI의 출시, 가격 변화, 신기술과 벤치마크를 다룹니다.
활성화 함수 FAct 재사용해 이미지 분류 정확도 개선
함수별로 학습 설정을 조정한 실험의 16개 조건 중 11개에서 고정한 FAct가 1위를 기록했다.
최근 7일11.17 – 11.22
일레븐랩스, 녹음·실시간 대화용 음성인식 모델 공개
녹음용 모델은 여러 사람이 말한 녹음에서 화자 분리를 평가했고, 실시간 모델은 발언이 끝났는지 판단했다. AI 삽화
기본 지시문으로 설정별 모의 시선을 가른 모델
연구진은 볼 곳을 글로 먼저 쓰게 한 방식이 시선과 무관한 속성 변화에도 반응했다고 보고했다.
구글, Gemini 4 Carbon 활용 사례 공개
실시간 입자 시뮬레이션과 공개 데이터 도구를 소개하고 개발자 유료 이용 경로를 안내했다.
루마니아어 문법 평가서 학습 데이터별 성능 차이
같은 학습량에서 BabyBabelLM이 영상 자막보다 대체로 우세했으며, 초록은 독립 재현 결과를 보고하지 않았다.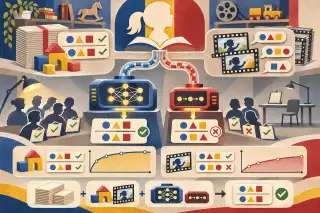
Databricks, AI 비용 비교 지수 공개
Databricks는 자체 코딩 평가에서 성공률이 같은 모델도 과제당 비용은 달랐다고 밝혔다.
Qwen4-Max 출시, 프리뷰 접근 조건은 별도
출시 공지의 도구 지원과 프리뷰의 전용 이용 조건은 별도 항목이다.
일주일 전11.10 – 11.14
미니맥스, 1600만 화소 직접 생성 모델 공개
디지털투데이는 별도 확대 없는 이미지 생성과 편집 지원, 자체 실행용 가중치 배포를 보도했다.
Chariot, 인도 언어 11개 음성 합성 모델 공개
언어 혼용부터 즉석 음성 복제까지, 보도가 소개한 기능은 다국어 지원에 그치지 않는다.
영어 토큰 줄인 다단어 학습, 모델 평가는 남았다
연구진은 압축 효과를 보고했지만, 이를 적용해 학습한 모델은 평가하지 않았다.
클로드 페이블 새 버전의 입력·출력 단가 인하
이전 버전보다 낮아진 단가와 별개로, 정보 보관 예외는 이용 서비스의 조건을 따른다.
튀르키예어 영상 검증 데이터셋으로 두 체계 비교
검증 기사에 번역·합성 사례를 보탠 TeViD는 근거 검색형과 추가 학습형의 판정 방식을 비교했다.
앤트로픽 차세대 모델 공개, 성능·속도 향상 주장
성능·속도 개선 발표와 스스로 학습한다는 질문은 구분해 판단할 사안이다.AI가 AI 가중치 고치는 능력, 일부 최신 모델에 쏠려
구조화 응답 과제는 모든 시도를 막았고, 한 과제의 성공과 다른 과제의 성공은 상관이 낮았다.
GeoJeV, 1.12초 더 써 정확도 5.32%p 향상
문장 생성 대신 확률 분포로 탐색을 제어했으나 7.8배 속도 비교의 상대 방법 이름은 초록에 없다.
MINE 연구진, RTX 4060 Ti 추론 2.52배 가속
연구진 공개 수치는 Llama 3.1 8B Instruct의 2.1비트 EntQuant 체크포인트 결과이고, RTX 5090에서는 1.48배였다.
GPT-6 Astra 생명과학 점수 22.9%포인트 향상
OpenAI와 Ligo가 함께 만든 시험에서 자사 모델끼리 비교한 회사 공개 수치다
2주 전11.03 – 11.08
ERNIE 5.5 Flash Base 공개…한국은 제외
사전학습만 마친 기본 모델 가중치를 연매출 기준으로 무료 개방했지만, 라이선스상 한국에서는 쓸 수 없다.
드리밍 늘리자 Claude 위키 문답 점수 48%로
회사 공개 수치로 검색을 병행한 점수는 61%였고, 실험 전체 비용은 회사가 밝히지 않았다
Drex Max, 결정 모델 평가서 67.52점 보고
선택지별 확률만 돌려주는 공개 모델의 점수와 응답시간은 저자 보고치이며, 독립 재현은 없다.
EU AI Act 평가서 전용 비서 다섯 중 둘만 기준 모델 앞서
전용 개발이 성능을 보장하지 못했다는 결과이며, 참가 시스템의 연동 코드와 과거 결과는 공개 범위에서 빠졌다.
3주 전10.26 – 11.02
Anthropic, AI 응답 증명 시스템 오픈소스 공개
가중치를 숨긴 채 응답의 출처 모델을 검사하는 구조지만, 서비스 적용 일정은 회사가 밝히지 않았다.
AI 연구 에이전트 실험 제안 415건 중 194건 통과
에이전트가 매긴 순위가 어떤 실험을 먼저 돌릴지 고르는 데 도움이 된다는 증거는 아직 제한적이다.Gemini 4 Carbon, 사이버 방어자에 먼저 제공
백만 토큰당 입력 $2·출력 $10 요금은 정해졌지만 개발자·기업·소비자 대상 제공 날짜는 공개되지 않았다.
OpenAI, GPT-6 Astra 음성 평가 선두 주장
OpenAI 사례 글 소개문이 든 평가 근거는 벤치마크 하나이고, 표본 규모와 평가 조건은 적혀 있지 않다
Greptile, GPT-6 Astra로 작업 흐름 시험
OpenAI는 Daybreak와 Codex의 쓰임도 소개했으나 제목과 소개문에 성과 수치는 없다.
CodeRabbit, GPT-6.1 Sol로 보안 조사
OpenAI는 보안 에이전트의 탐지 정확도와 오탐률을 밝히지 않았다.
GPT-6.1 Terra 공개, 100만 토큰당 입력 $1
표준 API 가격을 GPT-5.6 Terra 대비 50% 낮췄고, 사이버보안 능력은 회사 기준 Critical 수준으로 분류했다.
2026년 10월10.13 – 10.19
Mercury 3 공개, 입력 100만 토큰당 $0.20
확산 방식 모델의 파라미터를 40배 넘게 늘렸다고 회사는 밝혔고, 출시 할인의 종료일은 공개하지 않았다.
Mac Studio 4대로 816B 모델 구동 보고
Apple의 자체 측정값이며, 4비트 양자화가 답변 품질에 미친 영향은 보고되지 않았다AI 삽화Gemini 4 Argon 모의 사이버 공격 12개 해결 보고
회사가 보고한 수치로 외부 재현 여부는 밝히지 않았으며, 훈련 중 채점 조작 시도도 함께 보고됐다.
Gemini 4 Argon, 물리 추론 시험 87% 보고
회사 블로그의 시연은 실물 로봇과 시뮬레이션이 섞여 있고, 비교 모델별 점수는 실리지 않았다
Microsoft, AI 튜터 훈련용 학생 시뮬레이터 공개
실제 학생 시험 전 단계의 연구 시스템으로, 학습 성과 개선 여부는 회사가 밝히지 않았다.