AI
언어모델과 영상·이미지·음성 생성 AI의 출시, 가격 변화, 신기술과 벤치마크를 다룹니다.
영상 토큰 압축을 과제별로 비교한 VidToC
압축 효과는 영상 이해 과제에 따라 달랐고, 연구진은 모델의 기본 구조에 따른 차이도 비교했다.
최근 7일11.17 – 11.22
Higgsfield, 텍스트로 만든 8초 영상 비교 공개
Higgsfield는 생성 옵션을 한 번씩 실행한 비교에서 Seedance 2.5가 지시문을 가장 충실히 따랐다고 평가했다.
대조 학습 뒤 AI 안전장치 우회 탐지 정확도 상승
별도 분류기 훈련 없이 새 입력이 유해·무해 대표점 중 어디에 더 가까운지 판별하는 방식이다.
로봇 물체 배치 기법 DOCK, 모의 과제 15개 해결
집게에 잡힌 물체의 이동을 로봇 관절 각도로 추정해 학습에 썼다.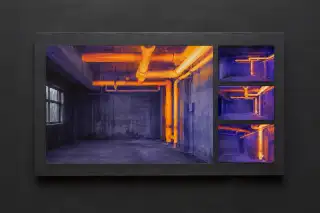
휴머노이드 보행 실험서 e-prop 생존율 100%
생물 신경계를 닮은 학습법이 비생물학적 비교 기준과 같은 생존율을 기록했다.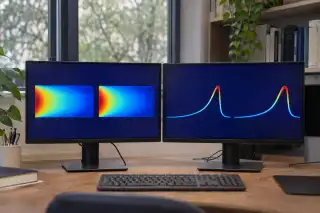
초록 저장한 논문 탐색 도구, 검색 순위 지표 개선
논문을 추천할 때 주제 관련성과 저자의 연구 이력을 점수에 반영하고 항목별 근거를 보여준다.
표면 모델 없이 물체 자세 추정하는 학습법 공개
물체의 자세와 실제 크기 표기로 표면 복원에 쓸 관측점을 고르는 방식이다.
숨소리까지 문장에 표시하는 음성 인식 모델 발표
연구진이 공개한 평가 결과에 따르면, 이 모델은 사람이 정답을 표시한 평가에서 평균 종합점수 선두를 차지했다.
번역 모델 압축 뒤 처리 시간 최대 5.3배로 증가
논문 초록에 따르면 메모리 사용량은 줄었고 종합 번역 점수는 대체로 약 1점 이내에서 변화했다. AI 삽화
CaDO, 인과 추론 데이터의 정답 오류 자동 보정
연구진은 질문을 검증 가능한 형식으로 바꾸고, 보정 과정에서 기존 정답을 얼마나 보존했는지 비교했다.
재난 게시물 사이 인과관계 찾는 STAGE 공개
연구진은 게시물 간 관계를 학습에 넣었을 때 산불과 허리케인에서 성능 개선 폭이 달랐다고 보고했다.
KIWI-EP, vLLM 출력 토큰당 시간 단축
전문가 모델에 토큰을 보내고 각 모델의 처리 결과를 모으는 방식을 재설계했다.AI 삽화1인칭 작업 영상 오류 탐지에서 통합 모델이 앞서
연구진 평가에서 동작 단계와 시간 구간, 수행 결과를 함께 예측한 모델이 분리형보다 높은 오류 탐지 점수를 기록했다.
영어·표준중국어 평가에서 나타난 모델별 맥락 추론 차이
연구진은 대화 문항에서 언어 모델이 사람 참가자보다 발화를 문자 그대로 해석하는 경향이 강했다고 보고했다.
일레븐랩스, 녹음·실시간 대화용 음성인식 모델 공개
녹음용 모델은 여러 사람이 말한 녹음에서 화자 분리를 평가했고, 실시간 모델은 발언이 끝났는지 판단했다.AI 삽화의학 객관식 한 번에 푸는 모델 정답률 46.0%
언어 모델을 고정하고 질문과 보기의 유사도를 비교하는 부분만 학습한 결과이다.
추가 학습 없는 언어 모델 가중치 복구 실험 공개
Pythia에서는 고정 투영법이 실시간 선택과 비슷한 성적을 냈고, 복합 결함에서는 두 절차가 같은 계열의 연산을 썼다.
뉴로퓨전의 세레핀, 포캐스트벤치 종합 1위
경제·금융 시계열과 예측시장 질문의 부문별 점수가 종합 순위에 같은 비중으로 반영된다.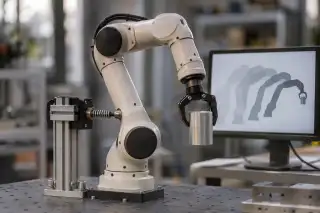
언어 모델 가중치에 재학습 없이 산술 회로 삽입
논문은 계산 규칙을 가중치에 옮기는 방식을 예제 기반 미세조정과 비교했다.
픽셀 생성 없는 전신 식별 모델 IDWorld 제안
같은 복장이나 고정된 시점에서 사람의 특징이 어떻게 달라지는지 예측해 식별에 반영하는 모델이다.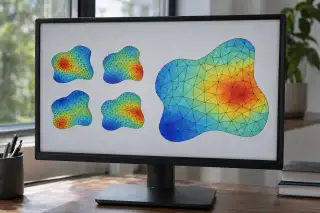
관측 기간 늘린 실험에서 고객 행동 예측 성능 상승
논문은 관측 기간을 늘렸을 때의 지표 상승 폭이 순차 모델 계열 간 차이보다 크다고 보고했다.
ReLay로 회로 배치 생성의 모델 호출 비용 절감
연구진은 기존 회로 배치에서 코드를 복원하고 반복되는 설계 절차를 공용 함수로 등록했다.
이미지 생성 캐시로 그림 속 단어 정확도 하락
연구진은 오차가 클 부분만 다시 계산하는 GuideCache로 입력 지시 반영 수준을 회복했다고 보고했다.
활성화 함수 FAct 재사용해 이미지 분류 정확도 개선
함수별로 학습 설정을 조정한 실험의 16개 조건 중 11개에서 고정한 FAct가 1위를 기록했다.
연구진, TuringPAI 차량 내 12 Hz 경로 생성 발표
논문은 차량 내 실행에 NVIDIA Orin-X 칩 하나를 썼다고 명시했다.AI 삽화목차로 긴 문서 구조 복원하는 TETHER 공개
TETHER는 별도 학습 없이 목차와 본문을 연결해 각 장과 절의 범위를 구분하는 방식이다.
문장 길이 조절로 확산 모델 번역 속도 높인 TRAC
연구진 실험에서 모델 호출 횟수는 줄었고 번역 품질 지표 COMET의 거시 평균은 0.02점 하락했다.
연구진, RoCoKV 시험서 추론 속도 향상 보고
연구진은 추론 중 모델의 확신에 따라 KV 캐시 압축 강도를 바꾸도록 설계했다.AI 삽화검색 증강 생성 시스템을 처음부터 짠 에이전트
시작 코드 없이 시스템을 짠 조합이 별도 실험에서 사람 설계의 점수도 높였다.
음식 무게에 비례하지 않은 AI의 열량 추정치
무게당 열량에 제시한 무게를 곱하자 적은 양과 많은 양에서 오차가 줄었다.
의료용 언어 모델 인증에 추론 단계 감사 제안
저자들은 정답 위주 평가가 잘못된 인과 추론을 놓칠 수 있다고 지적했다.
영상 언어 모델, 질문 없이 고른 입력도 상위권
연구진은 토큰 한도가 낮을 때 질문을 의미 단서로 나누는 방식이 특정 증거를 찾는 데 도움이 됐다고 밝혔다.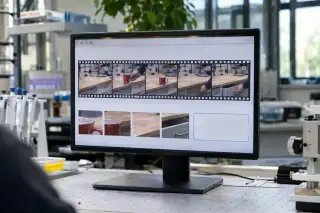
아이디오그램 4.6 이미지 편집 API 요금 공개
편집료는 해상도에 따라 다르고, 연속 편집 순위는 전작과 다른 설정에서 나온 결과이다.
시각언어 모델 추론 비용 낮춘 4비트 양자화
이미지와 글에서 정보를 찾는 구조를 보존하고, 추론 도중의 판단을 원래 모델에 맞춘 연구이다.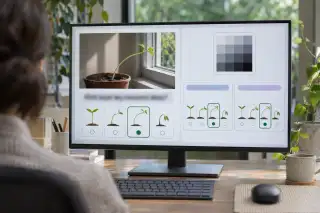
프로그램 추론 정확도 최대 22%포인트 개선
입출력 예시를 골라 묻는 알고리즘이 언어모델 단독 에이전트와 비교됐다.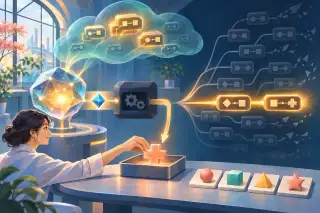
다윈 기상 AI, 국가 모델 비교서 최저 오차 주장
기존 예보 모델과 비교한 회사 공개 수치라는 점이 성능 주장을 읽는 기준이다.
AG-JEPA, 초기 인지장애 분류 성능 개선
연구진은 뇌 부위별 특징을 학습해 진단과 질병 진행 예측 성능을 높였다고 발표했다.
보안 과제 658개로 언어모델 훈련 환경 공개
실행 결과를 검증하는 학습 구조를 제시했으며, 공개 성적의 비교 기준은 CTF 보안 과제이다.
입력당 한 번 실행하는 에이전트 학습법 공개
FlashREINFORCE 연구진은 입력별 반복 실행을 줄이면서 학습 안정성을 유지했다고 밝혔다.
번역 모델 압축 연구, 평가지표에 따라 달라진 품질 판정
자동 평가 지표의 판단이 갈린 연구로, 압축 뒤 후보 번역을 다시 고르는 절차도 함께 다뤘다.
AI 추론을 그래프로 바꿔 정답 예측 성능 개선
연구진은 초기 계획과 종합 단계의 의존 관계에서 정답·오답 추론의 차이를 분석했다.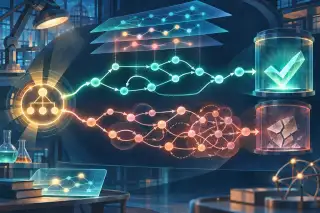
휴대전화 처방전 판독, 약물 재현율 67% 보고
같은 사진을 재평가한 연구는 약물 누락 감소와 처리 시간 증가를 함께 보고했다.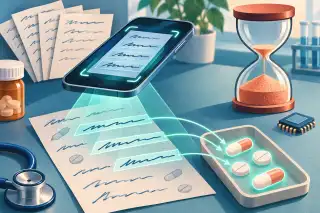
CECAR, 전문가 선택 바꿔 기기 내 추론 가속
기존 캐시 기반 경로 선택에 전문가 재사용 예측을 반영한 설계이다.
오답 학습으로 공간 추론 개선, 일반화는 제한
연구진은 공간 학습 문항에 따른 성과와 모델별 한계를 함께 보고했다.
언어모델 수정 효과는 평가 조건에 따라 달랐다
거부 제거와 어휘 축소 논문은 수정 뒤 동작을 평가 조건과 함께 살폈다.
CivilBench가 드러낸 토목 AI의 수치 추론 한계
연구진은 수치 사전정보와 외부 지식의 보완 효과도 모델의 근거 해석·활용 능력에 달렸다고 밝혔다.
뇌파 이해 평가에서 드러난 시각언어 모델의 정렬 병목
EEGProbe 연구진은 신호 없이 정답을 맞히는 지름길을 줄이고, 뇌파와 다른 형식의 정보를 연결하는 능력을 시험했다.
루마니아어 문법 평가서 학습 데이터별 성능 차이
같은 학습량에서 BabyBabelLM이 영상 자막보다 대체로 우세했으며, 초록은 독립 재현 결과를 보고하지 않았다.
하이퍼엑셀, 추론 효율 비교 내건 서버 공개 예고
전력·비용당 처리량을 비교한 회사 자체 시험과 국내 운영 서버를 연결하는 시연 계획이 발표의 중심이다.
AI가 짠 일정 최적화 코드, 미해결 문제 기록 개선
같은 장비와 실행 예산을 적용한 비교에서 AI 작성 코드가 상용 도구보다 작은 하한 격차를 기록했다.
시계열 예측 평가셋 공개…추세와 충돌한 글의 오차
과거 추세와 충돌한 글이 예측 오차를 키운 조건과 수정 폭을 제한한 효과를 살핀 연구이다.
로봇 제어 코드 재사용하는 ACE-CaP-0 공개
AI가 작성해 고정한 코드를 재사용하는 방식으로, 성공률은 저자들의 자체 실제 로봇 시험 결과이다.
대상별 탐지기 학습 없는 위성영상 검색 방식 평가
Lens 저자들은 위치 편향을 줄인 영상 특징으로 검색했으며, 클래스별 최적 임곗값에서 성능을 보고했다.AI 삽화PERFARENA, 생성 코드의 실행 비용 평가
정답 여부에 실행 시간·메모리·에너지 측정을 더한 코드 평가 도구이다.
언어 모델의 가중치 편집, 무작위 안내 대비 이점 없어
저자들의 반복 평가에서는 정밀도 차이가 작게 측정됐으며, 초기 가중치 편집 실행의 검증에도 한계가 보고됐다.
의료 AI의 미완성 추론에서 기존 진단 추출
연구진은 추론에 남은 진단과 답변 완성, 정답 여부를 구분했다.
광물 탐사 AI 평가서 필요 이상의 실험 제안
연구진은 필요한 실험을 찾는 재현율은 높지만 제안의 정밀도는 낮다고 보고했다.
언어 모델 평가, 정답 점수 넘어 내부 처리 추적
지식 회상과 추론 과제에서 나타나는 내부 처리 차이를 평가에 반영하는 틀을 제안했다.
시민의 AI 규칙 수정 돕는 AI-Voyager 제안
정부 문서의 근거 구절을 연결했지만 참여 연구에서 인용이 원문 확인으로 이어진 경우는 드물었다.AI 삽화소형 언어모델 반복 평가에도 남은 참여자 구성 영향
평가 결과를 합쳐도 참여자 구성의 영향은 남아, 연구진은 강제 순위 대신 후보군과 격차를 보고하도록 제안했다.
구글 딥마인드, 도면 읽고 보고서 쓰는 평가 공개
복잡한 시각 정보의 분석부터 업무 결과물 완성까지 평가 범위에 포함했다는 보도이다.
일주일 전11.10 – 11.16
맥 개발 명령 처리량 높인 메탈 샌드박스 공개
명령 처리량 실험과 세션 기록 추정치는 서로 다른 조건을 적용한 결과이다.
영상 이해 평가서 드러난 대사·발화자 연결 격차
연구진은 시각 정보의 효과가 질문 유형에 따라 달랐다고 밝혔다.
로컬 AI에 PC 조작 맡긴 XDA 필자의 경험담
PC 조작을 맡긴 경험에서 읽을 핵심은 필자의 편의와 성능 평가를 구분하는 기준이다.
회전기계 진단 모델, 정확도 99.40% 발표
연구진은 여러 운전 조건의 공개 데이터셋으로 평가했으며, 초록에 실제 산업 설비 검증 결과는 공개하지 않았다.
이미지 생성 AI 평가 순위 뒤집은 검증 방식
전체 점수가 비슷해도 개별 이미지 판정은 엇갈렸고, 모델 순위도 사람 평가와 달랐다.중국 판결문 생성 AI 평가할 진단 기준 공개
법률 특화 모델과 범용 모델의 강점은 평가 항목에 따라 달랐다는 연구 결과이다.산스크리트어 번역 AI, 언어 구조 더해 점수 개선
연구진이 밝힌 구절당 추론 비용은 단일 모델 대비 약 9배이다.GPU·CPU 혼합 풀이법, 최적화 문제 점수 개선
별도 학습 없이 GPU가 계산한 변수값을 CPU 풀이기에 전달하는 방식이다.Anthropic이 제안한 대화 전체 안전성 평가
Anthropic은 유해한 요청에 응하는 문제뿐 아니라 무해한 요청을 과도하게 거부하는 문제도 함께 평가해야 한다고 주장했다.
Sophon, 공개 모델의 공간 추론 병목 보정
연구진은 공간 정보를 갖춘 모델도 답변에 이를 활용하는 경로에서 실패한다고 분석했다.
MIGRO, 모델 교체 뒤 재구축 대비 품질 99.9% 유지
연구진은 기억을 모델과 분리해 후속 모델도 기록을 읽고 확장하도록 설계했다고 밝혔다.MOSS-Live 음성 지표 우위, 다중 대화 열세
배경 음성 오응답 비율과 다중 대화 성적은 평가 범위를 나눠 읽어야 했다.
가중치 일부 삭제로 전체 미세조정 수준 성능 향상
학습 결과의 저장 용량 감소와 기존 능력 유지가 함께 제시된 연구 발표이다.
추가 학습 없이 닮은 물체 가려내는 이미지 분할
물체 후보를 먼저 찾고 참조 이미지와 대조해 원하는 대상의 영역을 나누는 방식이다.로봇 동작 변화에 적응하는 세계 모델 AFTER-WM
연구진은 학습된 모델을 고치지 않고 지속 시간이 다른 보정을 결합하는 방식을 제안했다.재학습 없이 물리장 예측하는 PhysICL 공개
시뮬레이션 예시로 새 격자의 물리량 분포를 추론하며 모델 가중치를 고정한 방식이다.언어모델 오류 감지와 사전 경고 구분하는 평가법 제시
연구진은 응답 분류 점수가 비슷한 탐지기도 오류 전 경고 성과는 달랐다고 밝혔다.언어모델 교란 탐지, 분류기와 자기보고 격차
연구진은 교란 위치를 찾는 성공이 내부 계산 전반에 대한 접근을 뜻하지는 않는다고 지적했다.긴 문맥 AI 처리량 높인 토큰 병렬화 설계
모델을 나눠 배치하되 요청별 어텐션은 해당 서버에서 끝내는 구조가 처리량 비교의 핵심이다.
AVCC, 다음 발언자 예측에 사람 평가 기준 추가
단일 카메라·마이크로 기록한 대화에서 사람과 모델의 예측을 같은 사례로 평가하는 구성이다.
Alania-2, 터키어 음성 합성 오류율 낮춰
숫자와 이름을 발음대로 풀어 쓰는 변환기를 적용한 결과도 논문에 제시했다.
일레븐랩스, KPN과 네덜란드어 본인 확인 정확도 개선
네덜란드어 데이터로 모델을 추가 학습했으며, 정확도 평가 표본과 판정 기준은 공개하지 않았다.
확산 언어 모델 가속하는 블록 병렬 수정 기법 공개
B3는 추가 학습 없이 적용하는 방식으로, 연구진은 기존 모델과 동등한 생성 품질을 보고했다.
재게시 환경서 AI 조작 영상 탐지 한계 드러나
연구진은 생성기·내용 변화와 재게시 압축을 탐지 성능 저하의 별도 원인으로 분석했다.
아동의 비언어 상호작용 평가하는 AI 기준 제시
연구진은 시각언어모델이 맥락 인식보다 행동과 대인관계 단서 해석에서 약점을 드러냈다고 보고했다.
소규모 데이터 LIS의 안전 정렬 성능 개선 주장
연구진은 안전성과 과도한 거절을 함께 다뤘으며, 초록은 평가 모델과 벤치마크별 점수를 보고하지 않았다.
영어 토큰 줄인 다단어 학습, 모델 평가는 남았다
연구진은 압축 효과를 보고했지만, 이를 적용해 학습한 모델은 평가하지 않았다.
법률 AI, 추론과 정답의 학습 비중 조절법 제안
추론과 정답의 학습 비중을 맞추고, 최종 평가에 미치는 영향에 따라 보조 보상을 조정하는 방식이다.
다국어 문서 이해 평가서 언어별 성능 격차 지속
연구진은 모델 규모가 커져도 언어별 점수 차이가 줄지 않았다고 보고했다.
CaseScope 연구진, 병리 진단 불안정성 보고
공개 모델은 교육용 사례에서 추가 영상보다 검체 부위 정보에 더 크게 영향을 받았다고 연구진은 보고했다.
장소 검색, 원본과 다른 영상에서 정답률 하락
AcrossPlace 연구진은 설명의 원본 영상과 검색 대상 영상을 분리해 관측 변화에 따른 성능 차이를 보고했다.
망막 영상 맞추는 MICRO 벤치마크와 학습법 제안
연구진은 서로 다른 영상의 혈관 구조 유사성으로 위치를 맞추는 한 단계 학습법을 제안했다.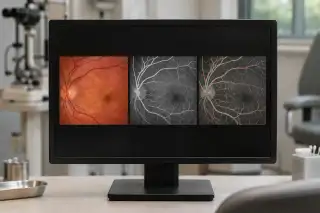
PolyRoute, 12개 언어 문의 분류 평가 기준 공개
평가 문장과 정답은 모두 AI로 생성했으며, 통계 분류기의 점수도 연구진 공개 수치로 91.9%이다.FERN, 생성형 AI 호출 없이 필수 표 검색 개선
Spider에서 순위 조정 효과를 제시했지만, Fiben 비교는 질문 집합이 다른 조건이다.
LiteLLM Rust 성능 주장을 읽는 비교 조건
처리 부담·메모리·비용 효율을 하나의 성능 결론으로 읽기 전에 비교 조건을 살펴야 한다.
Databricks, 기업 업무 맡는 Genie 발표
업무 맥락과 검색을 연결하고 관리자가 도구 접근과 지출 한도를 통제하는 구조이다.
구글 제미나이 4 하이드로젠, API·앱에 순차 제공
입력 문맥 전체에 단일 단가를 적용하고, 코딩과 여러 모델을 조합한 작업에 초점을 맞췄다.
E2VID 영상 복원 실험서 사람 탐지 40건 보고
연구진은 배경 오탐 비중을 제한한 사후 비교에서도 영상 복원과 직접 표현 방식의 탐지 차이를 보고했다.LEMMO가 긴 전자기 신호의 관계를 설명하는 방식
평가 범위를 신호 분류에서 상세 설명으로 넓혔으며, 개선 폭은 연구진이 제시한 비교 수치이다.
우주선 AI 기억 평가서 세션 재시작 뒤 성능 차이
연구진은 같은 세션의 평가에서 기억 시스템과 검색 증강 생성의 우열이 뚜렷하지 않았다고 보고했다.
회로 배치 AI 벤치마크, 검증 통과 결과만 채점
전기적 성능과 면적을 평가한 논문은 비슷한 점수의 실행 구성에서도 모델 비용이 크게 달랐다고 밝혔다.
AI 검증 거친 언어모델 평가서 어려운 문항 탈락
연구진은 AI 검증이 사람이 정답을 지지한 문항까지 걸러 평가 정답률을 높였다고 밝혔다.추론 중 실시간 수식 검사로 정확도 개선 보고
기호 수학 평가에서 정확도 개선과 토큰 사용량 증가를 함께 보고했으며, 초록은 독립 재현을 보고하지 않았다.구글, 시각 문서 업무 평가하는 새 벤치마크 공개
공통 실행 환경에서 결과물을 채점하며, 평가 과제는 비공개로 운영한다.
논문 심사자 추천 벤치마크 OmniReview 제안
연구자 전문성을 설명하는 프로필과 단계별 평가로 실제 편집 업무를 반영하도록 설계했다.Kaggle 수상작이 던진 AI 평가 설계의 과제
자체 평가를 요구한 대회의 취지는 순위보다 무엇을 시험했는지에 주목하게 했다.의료 AI 평가서 지침 지식과 근거 활용 격차
중국어 기반 평가에서 임상 정보 식별보다 근거 연결과 권고안 작성 점수가 낮게 제시됐다.과학 코드 번역 AI, 실패 유형 따라 수리 분담
실패별 수리 배정에 별도 검증을 더해, 토큰 사용량과 번역 정답률을 함께 평가했다.
경찰 영상 혼합형 AI, 사건 서술 13.6%가 근거 부족
연구진은 화자 오인과 함께 편집 영상·긴 영상·잡음 조건에서 모든 처리 체계의 성능 저하를 보고했다.
AI 허위정보 생성비, 검증비보다 3~169배 낮아
VEX-Bench는 허위정보의 검증 부담을 여러 차원에서 평가한 연구이다.AI 제조 모형 평가서 실행돼도 틀리는 오류 보고
기준 모형 비교에서 오류가 드러났으며, 초록은 독립 연구진의 재현 결과를 보고하지 않았다.
드라마 평가 AI의 채점 방식별 정확도 차이
심사 전 DramaGrow 논문은 반복 채점과 직접 쌍 비교를 대조하고, 평가 방식에 따른 성능 차이를 보고했다.
영상 AI의 물체 등장 횟수 계산 개선 연구 발표
합성 영상의 정확도 개선과 실제 영상 평가의 한계를 함께 제시했다.
터키어 모델 수학 추론, 선형 병합서 최대 개선
미세조정에서는 학습량보다 데이터 품질이 중요했다고 연구진은 밝혔다.
벡터 검색 MCGI, 데이터 굴곡 따라 탐색량 조절
검색 중 계산한 거리로 탐색량을 조절하는 방식이며, 성능 비교는 같은 색인을 사용한 조건이다.베트남어 문장부호 17종 비교, 추가 층 효과 엇갈려
여덟 에포크로 학습을 고정한 심사 전 결과로, 구조별 튜닝을 더했을 때 순위가 어떻게 바뀌는지는 보고되지 않았다.RoleWalk, CPU 코어 하나로 노드 백만 개 처리
학습 없는 구조 임베딩의 쟁점은 속도보다 좌표가 다른 그래프에서도 유지되는지이다.AI가 AI 가중치 고치는 능력, 일부 최신 모델에 쏠려
구조화 응답 과제는 모든 시도를 막았고, 한 과제의 성공과 다른 과제의 성공은 상관이 낮았다.GeoJeV, 1.12초 더 써 정확도 5.32%p 향상
문장 생성 대신 확률 분포로 탐색을 제어했으나 7.8배 속도 비교의 상대 방법 이름은 초록에 없다.크메르어 답변 채점에서 LLM 심판을 뺀 벤치마크 공개
채점 단계에서 심판은 빠졌지만 참조 답안은 여전히 LLM이 만들고, 사람 쪽 검증 기준은 원어민 한 명의 평가이다.동료 신호에 LLM 공개 정확도 최대 47.8포인트 하락
연구진은 다중 에이전트 평가에서 최종 합의뿐 아니라 그 합의가 비공개 판단을 반영하는지도 재야 한다고 썼다.화자 임베딩 벤치마크, 잡음 제거 먼저 하면 오류율 상승
논문은 입력 오디오를 그대로 두고 출력 벡터만 줄이라고 권고하지만 모델별 오류율 값은 초록에 없다Shapley 설명 기법 열 종 비교한 논문 공개
저자들은 실제 데이터에서 표준 지표가 서로 모순된 최선의 방법을 골랐고, 입력을 묶는 단위가 대체법 선택보다 중요했다고 밝혔다.아타리 게임 20종이 드러낸 시각 AI의 판단 한계
최신 시각언어모델은 물체의 움직임을 자주 놓치고 새 화면보다 글로 쌓인 기록에 기댔다는 연구 결과다.혼돈 삼체 머신러닝 벤치마크, 코드·데이터셋 공개
연구진은 안정성 예측과 장기 궤적 예측의 난도가 달랐다고 썼고, 모델별 정확도 격차는 초록에 없다지식 고정해 적용력 재는 한국어 LLM 평가 틀 공개
정확도 점수가 가리던 오답의 원인을 가르려는 설계이며, 평가 모델의 이름과 점수는 초록에 없다.
GPT-6 Astra 생명과학 점수 22.9%포인트 향상
OpenAI와 Ligo가 함께 만든 시험에서 자사 모델끼리 비교한 회사 공개 수치다
네이버, 멀티모달 학습 처리량 150.2%로 높여
비전 인코더 재구현과 이미지 부담 재배치가 이득을 끌어냈고, 결과는 30B 모델 하나에서 잰 회사 공개 수치다.
2주 전11.03 – 11.09
GPU 없이 64GB 램에서 284B DeepSeek 실행
파일을 56.56GiB로 줄인 대신 패치하지 않은 llama.cpp·Ollama·LM Studio에서는 실행할 수 없다.METR가 본 Anthropic AECI 가속 1.9배
METR는 가속의 약 80%를 AI 몫으로 봤지만, 판단에 쓴 근거 다수는 Anthropic이 비공개로 가렸다.
ERNIE 5.5 Flash Base 공개…한국은 제외
사전학습만 마친 기본 모델 가중치를 연매출 기준으로 무료 개방했지만, 라이선스상 한국에서는 쓸 수 없다.
드리밍 늘리자 Claude 위키 문답 점수 48%로
회사 공개 수치로 검색을 병행한 점수는 61%였고, 실험 전체 비용은 회사가 밝히지 않았다
애플 KeyNet, 회사 공개 수치로 검색 최대 약 8배 단축
질의 분포를 미리 학습해 RAG 검색 비용을 줄이는 연구로, 사전 학습 시간은 공개 글에 없다.Cohere 검색 모델, OpenRouter 제공 시작
같은 API 키로 검색 파이프라인을 묶을 수 있지만 토큰당 요금은 발표에 나오지 않았다.
EU AI Act 평가서 전용 비서 다섯 중 둘만 기준 모델 앞서
전용 개발이 성능을 보장하지 못했다는 결과이며, 참가 시스템의 연동 코드와 과거 결과는 공개 범위에서 빠졌다.3주 전10.26 – 10.29
Gemini 4 Carbon, 사이버 방어자에 먼저 제공
백만 토큰당 입력 $2·출력 $10 요금은 정해졌지만 개발자·기업·소비자 대상 제공 날짜는 공개되지 않았다.OpenAI, GPT-6 Astra 음성 평가 선두 주장
OpenAI 사례 글 소개문이 든 평가 근거는 벤치마크 하나이고, 표본 규모와 평가 조건은 적혀 있지 않다
GPT-6.1 Terra 공개, 100만 토큰당 입력 $1
표준 API 가격을 GPT-5.6 Terra 대비 50% 낮췄고, 사이버보안 능력은 회사 기준 Critical 수준으로 분류했다.
2026년 10월10.12 – 10.25
Meta 연구진, 착용형 AI 비서 평가 과제 120개 공개
답변 글이 아니라 가상 세계의 최종 상태로 채점하지만, 저장소 안내문에 모델별 통과율은 없다.
Mercury 3 공개, 입력 100만 토큰당 $0.20
확산 방식 모델의 파라미터를 40배 넘게 늘렸다고 회사는 밝혔고, 출시 할인의 종료일은 공개하지 않았다.
MiniMax, M3.1 Flash를 API로 출시
회사는 에이전트 작업 비용 70% 절감을 내세웠지만 전 모델 요금과 가중치 공개 시점은 밝히지 않았다.
기업용 에이전트 평가 통합한 EGI-BENCH 공개
모든 능력 축을 앞선 모델은 없었다고 저자들은 보고했으나 deep 모드 점수는 초록에 실리지 않았다.
DeepSeek, 요금 유지한 Flash 새 버전 공개
자체 검색 API도 함께 열었지만 이전 출시판 점수의 측정 프레임워크는 공개되지 않았다
Magnetar, 영지식 증명 평균 10~39배 가속
표준 해시 함수에만 보안을 둔 범용 증명 시스템이지만 제품 출시 일정과 이용 조건은 공개되지 않았다
Mac Studio 4대로 816B 모델 구동 보고
Apple의 자체 측정값이며, 4비트 양자화가 답변 품질에 미친 영향은 보고되지 않았다AI 삽화Apple SSR 논문, 턴당 추론 지연 90% 넘게 줄여
자유 서술 대신 미리 정한 후보를 고르는 방식으로 소형 모델의 추론 비용을 줄였고, 제품 적용 계획은 밝히지 않았다
Gemini 4 Argon 모의 사이버 공격 12개 해결 보고
회사가 보고한 수치로 외부 재현 여부는 밝히지 않았으며, 훈련 중 채점 조작 시도도 함께 보고됐다.
Gemini 4 Argon, 물리 추론 시험 87% 보고
회사 블로그의 시연은 실물 로봇과 시뮬레이션이 섞여 있고, 비교 모델별 점수는 실리지 않았다
Microsoft, AI 튜터 훈련용 학생 시뮬레이터 공개
실제 학생 시험 전 단계의 연구 시스템으로, 학습 성과 개선 여부는 회사가 밝히지 않았다.
Apple 논문, 번역 평가서 LLM과 사람 일치도 비교
사람의 번역 평가를 LLM으로 대신하려면 언어쌍과 분야별 검증이 먼저라는 주장이다.
Meta, 에이전트 모델 Muse Wonder 공개
성능 근거는 회사 공개 수치이며, API 요금과 전체 안전성 보고서의 공개일은 발표문에 없다.