AI
언어모델과 영상·이미지·음성 생성 AI의 출시, 가격 변화, 신기술과 벤치마크를 다룹니다.
대조 학습 뒤 AI 안전장치 우회 탐지 정확도 상승
별도 분류기 훈련 없이 새 입력이 유해·무해 대표점 중 어디에 더 가까운지 판별하는 방식이다.
최근 7일11.17 – 11.22
의료 AI 조작, 답변보다 내부 신호에서 더 자주 탐지
연구진은 기존 변환 도구와 범용 판정 모델로 재학습 없이 실험했다.
담낭 수술 영상에서 안전 기준 오승인 줄인 판정법
전문가 의견이 갈린 영상의 오승인과 안전 기준을 충족한 영상의 제때 승인율이 함께 낮아졌다.
조회 누락을 짚은 구조화 기록은 답변과 겹쳤다
핵심 항목의 판정이 사전에 정한 사람 검증 기준에 못 미쳐 저자는 기록을 추가한 효과를 결론 내리지 않았다.
앤스로픽 전 연구원, 대형 영리기업의 AI 개발 비판
퇴사 때 사람의 생명이 위험에 놓였다고 주장한 콕슨은 AFP 인터뷰에서 AI 개발 주체를 문제 삼았다.
데이터브릭스, 규제 산업 AI 설계 4가지 공개
업무 결과를 규칙으로 판정할 수 있는지, 담당자의 판단이 필요한지에 따라 에이전트의 권한을 정하는 설계이다.
로고가 가시광·적외선 영상 AI 응답에 미친 영향
연구진은 두 종류의 영상에서 목표 응답이 동시에 최상위에 오르는지를 비교했다.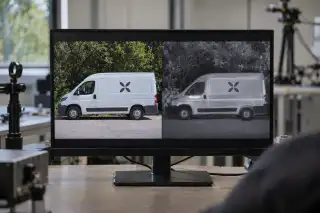
과수원 새 쫓는 국산 AI, 대응 횟수 감소의 의미
장치의 대응 횟수가 줄었다는 보도와 농작물 피해를 줄였다는 주장은 구분할 대상이다.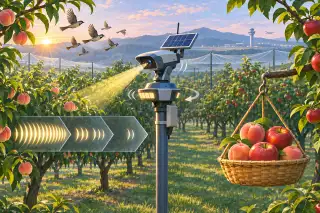
AI 결제 지출 예산, 체인 넘어 지갑별로 합산
sra-riskgate는 지갑별 지출을 합산하지만 동시 검사에는 제약을 명시했다.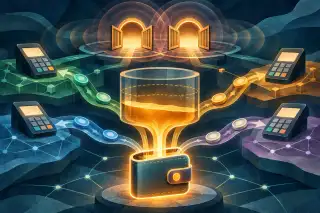
일주일 전11.10 – 11.15
Anthropic이 제안한 대화 전체 안전성 평가
Anthropic은 유해한 요청에 응하는 문제뿐 아니라 무해한 요청을 과도하게 거부하는 문제도 함께 평가해야 한다고 주장했다.
언어모델 오류 감지와 사전 경고 구분하는 평가법 제시
연구진은 응답 분류 점수가 비슷한 탐지기도 오류 전 경고 성과는 달랐다고 밝혔다.
언어모델 교란 탐지, 분류기와 자기보고 격차
연구진은 교란 위치를 찾는 성공이 내부 계산 전반에 대한 접근을 뜻하지는 않는다고 지적했다.
제목의 감정 표현 따라 달라진 AI의 심각도 평가
논문은 기사 본문을 함께 제공하자 제목 표현에 따른 심각도 편향이 줄었다고 보고했다.
소규모 데이터 LIS의 안전 정렬 성능 개선 주장
연구진은 안전성과 과도한 거절을 함께 다뤘으며, 초록은 평가 모델과 벤치마크별 점수를 보고하지 않았다.
호주 AI 안전장치 의무화가 남긴 위험 선택의 문제
의무 규칙의 도입과 규제가 겨냥할 위험의 적절성은 구분해서 읽어야 한다.
시각언어모델 안전 점수 보정으로 유해 응답 감소 보고
연구진은 유해 응답과 과잉 거절의 허용 비율을 학습에 반영하고, 점수 보정의 효과를 비교했다고 보고했다.
OpenAI, 아동 AI 안전 연구에 자금 지원
지원 목적은 청소년에게 AI가 주는 위험과 기회를 측정하는 공동 도구의 연구이다.
뉴욕주 연구센터가 AI 모델 독립 시험 추진
기업의 설명을 외부에서 점검한다는 계획의 의미는 시험 결과와 구분해 읽어야 한다.
자연스러운 안전 응답으로 추가 학습 뒤 안전성 개선
연구진은 정형화된 거절문 대신 요청 맥락에 맞춘 응답을 학습시키는 NEST를 제안했다.
바이낸스, iOS 앱 격리 우회 취약점 경고
개발자 시험 기록에는 적용 버전과 설치 조건이 명시됐으며, 연구자는 탈옥과의 관련성을 부인했다.
KTC, 디지털의료제품 연구 성과발표회 개최
시험기관·병원·대학이 참여해 안전성과 신뢰성 확보를 위한 연구 방향을 논의하는 자리이다.
클로드 페이블 새 버전의 입력·출력 단가 인하
이전 버전보다 낮아진 단가와 별개로, 정보 보관 예외는 이용 서비스의 조건을 따른다.
재학습 없이 미세조정 모델의 거절 행동 복원 제안
연구진은 기본 모델의 거절 방향을 옮겨 안전성을 개선하면서 분야별 지식을 유지했다고 보고했다.
언어 모델의 지속 기억 제어법 JCMC 제안
기억의 예측 효과를 적용 뒤 대조하는 설계로, 단순 검색과의 비교 성능은 제시하지 않았다.
오픈AI, 위험 작업의 추가 출력 35초 내 차단
모델을 종료하지 않고 문제 작업의 실행 권한을 차단해 다른 연구를 유지하는 설계이다.OpenAI, 연구 인프라 모델 작업 중단 체계 소개
사람의 통제를 내건 소개문은 누가 어떤 기준으로 작업을 멈추는지 밝히지 않았다.
숭실대, 자율 침투 AI 가짜 서버로 유인해 무력화
국가 배후 해킹에 쓰였다고 공개된 도구가 실험 상대였고, 실제 운영 서버에 적용한 사례는 공개 자료에 없다.
2주 전11.08
METR가 본 Anthropic AECI 가속 1.9배
METR는 가속의 약 80%를 AI 몫으로 봤지만, 판단에 쓴 근거 다수는 Anthropic이 비공개로 가렸다.
3주 전10.26 – 11.02
Anthropic, AI 응답 증명 시스템 오픈소스 공개
가중치를 숨긴 채 응답의 출처 모델을 검사하는 구조지만, 서비스 적용 일정은 회사가 밝히지 않았다.
OpenAI, ChatGPT 폭력 예방 조치 강화
안전장치 확대와 조기 개입을 내세웠으나 조치별 적용 시점과 효과 수치는 발표 요지에 빠졌다GPT-6.1 Terra 공개, 100만 토큰당 입력 $1
표준 API 가격을 GPT-5.6 Terra 대비 50% 낮췄고, 사이버보안 능력은 회사 기준 Critical 수준으로 분류했다.
2026년 10월10.12 – 10.23
OpenAI, 폴란드 NASK와 AI 안전·보안 협력
안전장치 강화를 목표로 내걸었으나 구체 과제와 협력 기간은 발표 요약에 제시되지 않았다
Anthropic, 불법 증류 90% 넘게 줄였다고 보고
감소 폭은 회사 보고치이며 표본과 측정 기간은 공개 소개문에 나오지 않는다.
Meta, 에이전트 모델 Muse Wonder 공개
성능 근거는 회사 공개 수치이며, API 요금과 전체 안전성 보고서의 공개일은 발표문에 없다.