AI
언어모델과 영상·이미지·음성 생성 AI의 출시, 가격 변화, 신기술과 벤치마크를 다룹니다.
CaDO, 인과 추론 데이터의 정답 오류 자동 보정
연구진은 질문을 검증 가능한 형식으로 바꾸고, 보정 과정에서 기존 정답을 얼마나 보존했는지 비교했다.
최근 7일11.17 – 11.22
더존비즈온, 공공기관용 행정 AI 에이전트 공개
회사는 기관 데이터를 외부로 보내지 않고 내부망에서 처리하는 방식이라고 설명했다. AI 삽화
심플렉스 AI, 개인용 에이전트 Linger 코드 공개
인터넷 없이 작동하는 범위와 라이선스가 허용하는 코드 이용 범위가 도입의 판단 기준이다.AI 삽화ReLay로 회로 배치 생성의 모델 호출 비용 절감
연구진은 기존 회로 배치에서 코드를 복원하고 반복되는 설계 절차를 공용 함수로 등록했다.
조회 누락을 짚은 구조화 기록은 답변과 겹쳤다
핵심 항목의 판정이 사전에 정한 사람 검증 기준에 못 미쳐 저자는 기록을 추가한 효과를 결론 내리지 않았다.
일레븐랩스가 공개한 동시 통화 한도 초과 요금
기본 한도를 넘겨 연결한 통화에는 유료 요금제의 추가 통화 시간과 다른 분당 요율을 적용했다.AI 삽화데이터브릭스, 파이프라인 장애 대응 AI 공개 베타
장애가 감지되면 로그를 조사하고 수정안을 격리 환경에서 검증하는 에이전트이다.
데이터브릭스, 규제 산업 AI 설계 4가지 공개
업무 결과를 규칙으로 판정할 수 있는지, 담당자의 판단이 필요한지에 따라 에이전트의 권한을 정하는 설계이다.AMD, PC 내장 칩으로 에이전트 추론 지원
Unsloth Desktop이 AI 모델 추론을 PC 내장 신경망처리장치에서 실행하도록 지원한다.
검색 증강 생성 시스템을 처음부터 짠 에이전트
시작 코드 없이 시스템을 짠 조합이 별도 실험에서 사람 설계의 점수도 높였다.
의료용 언어 모델 인증에 추론 단계 감사 제안
저자들은 정답 위주 평가가 잘못된 인과 추론을 놓칠 수 있다고 지적했다.
AI 영업 자동화가 시연 뒤 맞닥뜨린 실운영 과제
기업 조사에서 후속 행동 준비까지, 시연에 성공한 절차를 실제 업무에서 안정적으로 돌리는 일은 별도의 기술 과제이다.
데이터브릭스, 미국 정부 클라우드 새 환경 베타 공개
베타는 비운영 업무용이며, AI 기능과 정부 보안 인증은 후속 계획에 포함됐다.프로그램 추론 정확도 최대 22%포인트 개선
입출력 예시를 골라 묻는 알고리즘이 언어모델 단독 에이전트와 비교됐다.
스페인어 운임 협상 음성 AI 비교 결과 공개
금액 인식 오류율과 청취자 기준 응답 지연을 함께 비교한 연구이다.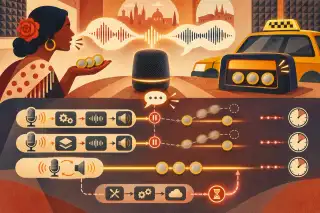
WebArena-Pro, 음성·영상 웹 에이전트 평가
서로 다른 모델을 결합한 Codex와 Claude Code가 공동 최고 점수로 보고됐다.
SuperDial, 의료 AI 간 통화 낭비 줄일 개편
음성 업무 자동화의 구조 변경과 실제 연산 절감 성과는 구분해서 읽어야 했다.
보안 과제 658개로 언어모델 훈련 환경 공개
실행 결과를 검증하는 학습 구조를 제시했으며, 공개 성적의 비교 기준은 CTF 보안 과제이다.
Gemini, 예약·구매 대행 기능 무료 제공 시작
한국도 무료 업데이트 대상에 포함됐으며, 고급 기능과 문자·이메일 접수는 미국부터 제공된다.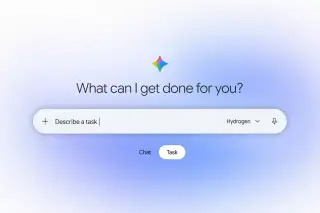
입력당 한 번 실행하는 에이전트 학습법 공개
FlashREINFORCE 연구진은 입력별 반복 실행을 줄이면서 학습 안정성을 유지했다고 밝혔다.
ElevenLabs, Kotoba 인수 추진
일본어 기업 대화를 겨냥한 인수로, 회사는 제품 통합 시점을 공개하지 않았다.
Apple의 Mac AI 에이전트 디스크 접근 통제 추가
에이전트가 맡을 작업을 판단하는 출발점은 디스크 접근 권한의 경계이다.
구글, 보안 패치 분석부터 실행까지 AI 공격 자동화 보고
패치 분석과 공격 실행을 잇는 자동화 주장에서 핵심은 사람의 개입이 줄어든 작업 범위다.
Cohere, 영상 속 답변 구간 검색 기능 공개
문서와 영상을 함께 검색하는 기능을 선보이고 설계 협력사 모집을 시작했다.
Databricks, AI 비용 비교 지수 공개
Databricks는 자체 코딩 평가에서 성공률이 같은 모델도 과제당 비용은 달랐다고 밝혔다.게임 엔진 간 장면 구성 경험 재사용 설계 공개
SceneAgent는 장면 구성 경험을 엔진 연동부와 분리했고, 지침 재사용에 따른 실행 비용도 검토 대상으로 제시했다.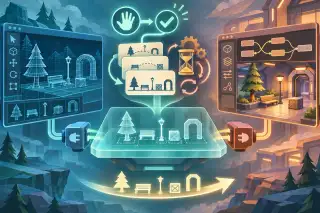
AI가 짠 일정 최적화 코드, 미해결 문제 기록 개선
같은 장비와 실행 예산을 적용한 비교에서 AI 작성 코드가 상용 도구보다 작은 하한 격차를 기록했다.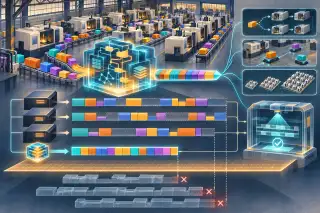
OpenAI 의료용 컴퓨터 사용 에이전트 발표
임상 답변 개선과 의료 소프트웨어에서의 작업 수행을 함께 내세운 발표이다.
Google 지도, 여행 일정 생성·예약 탐색 추가
여행 일정과 저장 목록 검색은 Ask Maps 제공 지역에, 예약 탐색은 미국에 먼저 도입하는 방식이다.
로봇 제어 코드 재사용하는 ACE-CaP-0 공개
AI가 작성해 고정한 코드를 재사용하는 방식으로, 성공률은 저자들의 자체 실제 로봇 시험 결과이다.
AI 결제 지출 예산, 체인 넘어 지갑별로 합산
sra-riskgate는 지갑별 지출을 합산하지만 동시 검사에는 제약을 명시했다.
발신 음성 AI의 통화 상대 가려내는 FEND 제안
사람과 음성사서함·자동응답 시스템·AI를 구분해 서로 다른 통화 대응을 돕도록 설계됐다.
퀄컴, 국내 체험 행사서 에이전틱 AI 활용 방향 소개
테크M은 퀄컴이 질문 응답을 넘어 상황을 이해하고 일을 제안·실행하는 AI의 방향을 소개했다고 보도했다.
광물 탐사 AI 평가서 필요 이상의 실험 제안
연구진은 필요한 실험을 찾는 재현율은 높지만 제안의 정밀도는 낮다고 보고했다.
구글 딥마인드, 도면 읽고 보고서 쓰는 평가 공개
복잡한 시각 정보의 분석부터 업무 결과물 완성까지 평가 범위에 포함했다는 보도이다.일주일 전11.10 – 11.16
맥 개발 명령 처리량 높인 메탈 샌드박스 공개
명령 처리량 실험과 세션 기록 추정치는 서로 다른 조건을 적용한 결과이다.
로컬 AI에 PC 조작 맡긴 XDA 필자의 경험담
PC 조작을 맡긴 경험에서 읽을 핵심은 필자의 편의와 성능 평가를 구분하는 기준이다.
산스크리트어 번역 AI, 언어 구조 더해 점수 개선
연구진이 밝힌 구절당 추론 비용은 단일 모델 대비 약 9배이다.
Bland가 말하며 듣는 음성 모델 Tofu-1 공개
DEV.to 보도는 통화 중 동시 청취·발화 기능과 후속 음성 모델군 계획을 소개했다.
Agentforce Coworker 이용자 집계 공개
회사 자체 집계인 초기 이용 규모와 업무용 에이전트의 성과는 구분할 대상이다.
Genie, Slack에서 질문자 권한으로 답변 생성
질문자 권한으로 만든 답변은 채널에 기본 공개되며, 문서 변경은 사용자 승인 뒤 실행하는 구조이다.
디스팅트, AI 결합한 창작자 매니지먼트 출범
디스팅트는 전문 에이전트의 대리 업무에 기술을 결합하고 비전속 모델을 채택했다고 보도됐다.
OpenAI, 사용자 승인받는 에이전트 결제 지갑 공개
ChatGPT Wallet은 사용자 승인과 기존 카드 보호 장치를 결제 조건으로 제시했다.구글, 기업용 에이전트 관측·비용 통제 기능 확대
대화 기록은 고객 소유 테이블에 저장하고, 일일 토큰 할당량은 미리보기로 제공했다.
피클의 카톡 중단으로 짚은 AI 대행의 접속 조건
AI에 맡길 업무를 정할 때 연결 대상 서비스의 허용 범위도 함께 살필 사안이다.
삼성SDS, 석유공사 AI 사업 우선협상자 선정
공사 내부 데이터에 검색증강생성을 적용하고 여러 AI 에이전트를 업무에 활용하는 구축 사업이다.
Buzz, 코딩 에이전트의 모델 선택 구조 공개
동료의 코딩 검토와 에이전트별 모델 선택을 한 공간에 모았지만, 조합별 비용 수치는 공개하지 않았다.
루마가 제시한 모바일 AI 영상 도구의 선택 기준
Luma는 생성 이후의 수정과 납품을 선택 기준으로 제시하고, 이를 자사 서비스의 장점과 연결했다.
Google, 선택지에 점수 매기는 판단 API 공개
공유 입력은 요청마다 한 번 과금하며, 지연 시간은 입력 길이와 질문 수의 조건을 따로 제시한 발표이다.
일레븐랩스, 업종별 음성 AI 앱 마켓플레이스 공개
업종별 앱을 찾아 파트너와 도입을 협의하는 구조이며, 기존 약정 구매는 향후 계획이다.
인텔, AI 에이전트 실행 플랫폼으로 PC 전환 제시
AI타임스는 인텔이 PC의 업무 실행과 산업 현장의 AI 활용 확대를 함께 제시했다고 보도했다.
일레븐랩스, 회의 비서 ElevenAI 무료 사전 공개
참석자 동의를 받아 회의를 기록하고 요약과 후속 할 일을 전달하는 기업용 앱이다.
ElevenLabs, 기업용 AI 도입 파트너 지원 확대
회사는 기술 인증과 공동 영업을 확대하고, 구축 서비스에서 파트너와 경쟁하지 않겠다고 밝혔다.
ElevenLabs, 기업용 대화형 AI 제휴
음성 기술에 기업 시스템 연동을 더해 고객 요청을 처리하고 보험 업무로 확대하는 구상이다.
Gemini·Claude가 안내한 휴대전화 작업 범위
작업 대상은 앱과 연결 기능으로 나뉘며, Gemini 화면 자동화는 국내 지원 기기 조건을 둔 기능이다.
Databricks, Power BI에 지표 게시 지원
계정팀을 통해 시험 참여를 신청하며, 지표 변경은 게시 작업으로 자동 반영하는 방식이다.
Databricks, 기업 업무 맡는 Genie 발표
업무 맥락과 검색을 연결하고 관리자가 도구 접근과 지출 한도를 통제하는 구조이다.
IBM·MS, 에이전트와 기업 시스템 잇는 플랫폼 공개
보도에 나온 규모는 에이전트와 관련 기술 자산을 포함한 수치이며, 플랫폼의 핵심은 이를 기업 업무에 연결하는 구조이다.
에이전트 스킬의 절차를 코드로 분리한 PASE
재사용 절차를 실행 프로그램으로 옮겨 자연어 문서의 반복 수정을 줄이는 설계이다.
우주선 AI 기억 평가서 세션 재시작 뒤 성능 차이
연구진은 같은 세션의 평가에서 기억 시스템과 검색 증강 생성의 우열이 뚜렷하지 않았다고 보고했다.
ElevenLabs 실시간 전사에 화자 구분 기능 추가
실시간 화자 구분 점수는 전사 오류를 보정한 결과로, 녹음용 평가와 직접 비교할 수 없는 수치이다.회로 배치 AI 벤치마크, 검증 통과 결과만 채점
전기적 성능과 면적을 평가한 논문은 비슷한 점수의 실행 구성에서도 모델 비용이 크게 달랐다고 밝혔다.구글, 시각 문서 업무 평가하는 새 벤치마크 공개
공통 실행 환경에서 결과물을 채점하며, 평가 과제는 비공개로 운영한다.
네이버, 커머스API 검수·호출·답변에 AI 적용
같은 API 명세를 자동 검수와 문의 답변, AI의 도구 호출에 활용한 설계를 소개했다.
코파일럿 CLI, 병렬 작업 승인·중단 절차 수정
병렬 요청의 승인 처리와 연결된 셸의 종료 범위를 손봤으며, 실행 전 계획 검토와는 제어 단계가 다른 변경이다.
파인튜닝 축소 속 에이전트 오류 수정의 기준
새 학습 작업의 종료와 기존 모델의 실행은 다른 일정이며, Werk는 모델에 전달할 사실을 먼저 강조했다.
과학 코드 번역 AI, 실패 유형 따라 수리 분담
실패별 수리 배정에 별도 검증을 더해, 토큰 사용량과 번역 정답률을 함께 평가했다.
튀르키예어 영상 검증 데이터셋으로 두 체계 비교
검증 기사에 번역·합성 사례를 보탠 TeViD는 근거 검색형과 추가 학습형의 판정 방식을 비교했다.
딥브레인AI, 대화형 영상 제작·업무 훈련 통합
영상 제작 절차를 처리하는 기능과 기업 업무의 대화 상대가 되는 아바타가 한 플랫폼에 묶였다.
Luma, Midjourney 한계 짚고 편집 기능 제시
Luma는 개별 요소 수정과 영상 후반 작업 연결을 자사 기능의 차이로 제시했다.구글딥마인드, AI로 Signal 핵심 코드 검증
전문가가 정한 보안 조건을 실행 코드까지 증명하고 Lean으로 검사했다고 밝혔다.JevGPT, 증거 검토와 연구 계획 나눈 이중 체계 제시
빠른 근거 검토를 연구 계획에 연결했으며, 초록에는 성능 점수와 비용을 제시하지 않았다.AI 허위정보 생성비, 검증비보다 3~169배 낮아
VEX-Bench는 허위정보의 검증 부담을 여러 차원에서 평가한 연구이다.
AI 제조 모형 평가서 실행돼도 틀리는 오류 보고
기준 모형 비교에서 오류가 드러났으며, 초록은 독립 연구진의 재현 결과를 보고하지 않았다.Google Cloud 의료용 Gemini 시험 제공 발표
진료 기록 정리와 보험 서류 준비를 지원하며, Epic 연동은 읽기 전용으로 설계했다.무료 모델 이전 때 입력 파일 달라질 수 있다는 경고
정상 응답 뒤에서 검토 에이전트의 입력이 바뀐다는 주장이지만, 파일 누락의 빈도와 규모를 잰 값은 공개되지 않았다.
검색기 없이 셸 명령으로 찾는 다국어 에이전트 MARS
저자들은 기존 방식을 앞섰다고 밝혔지만 초록에는 정확도 격차와 실험 언어의 수가 없다.
딥브레인AI, 대화로 영상 만드는 AI스튜디오 5.0 출시
회사는 구성안을 먼저 제안하는 제작 순서를 내세웠고 요금과 크레딧 소모량은 남은 질문이다숭실대, 자율 침투 AI 가짜 서버로 유인해 무력화
국가 배후 해킹에 쓰였다고 공개된 도구가 실험 상대였고, 실제 운영 서버에 적용한 사례는 공개 자료에 없다.동료 신호에 LLM 공개 정확도 최대 47.8포인트 하락
연구진은 다중 에이전트 평가에서 최종 합의뿐 아니라 그 합의가 비공개 판단을 반영하는지도 재야 한다고 썼다.
화자 임베딩 벤치마크, 잡음 제거 먼저 하면 오류율 상승
논문은 입력 오디오를 그대로 두고 출력 벡터만 줄이라고 권고하지만 모델별 오류율 값은 초록에 없다
Elith·NVIDIA, 일본 금융 페르소나 9M개 공개
레코드당 필드 50개로 실제 고객 기록 없는 금융 AI 개발을 겨냥했지만, 공식 통계와의 일치도는 공개하지 않았다.
2주 전11.04 – 11.06
드리밍 늘리자 Claude 위키 문답 점수 48%로
회사 공개 수치로 검색을 병행한 점수는 61%였고, 실험 전체 비용은 회사가 밝히지 않았다
OpenAI, 커널 취약점 948건 패치 생성 발표
OpenAI는 발견부터 패치 생성까지 자율 파이프라인이 맡았다고 밝혔지만, Linux 커널 반영 여부는 설명 문장에 없다.
3주 전10.26 – 11.02
DeepSeek, 저장소 맡는 코딩 에이전트 시제품 공개
요청과 팀 규칙에 따라 움직이는 연구용 코드로, 정식 출시일과 판매 가격은 나오지 않았다.
datasette-llm, llm 기본 모델 자동 적용
API 키가 없거나 설정에서 제외된 모델이면 모델 ID 없는 호출은 오류로 끝난다.
AI 연구 에이전트 실험 제안 415건 중 194건 통과
에이전트가 매긴 순위가 어떤 실험을 먼저 돌릴지 고르는 데 도움이 된다는 증거는 아직 제한적이다.OpenAI, Legora의 법률 업무 활용 사례 공개
소개 문구는 도입 목적을 적었지만 업무 시간 단축 폭은 담지 않았다.OpenAI, GPT-6 Astra 음성 평가 선두 주장
OpenAI 사례 글 소개문이 든 평가 근거는 벤치마크 하나이고, 표본 규모와 평가 조건은 적혀 있지 않다
월드 모델 Genie 4, 신뢰 테스터에 배포 시작
장면과 소리를 실시간으로 함께 만드는 모델이지만 일반 제공 날짜와 요금은 공개되지 않았다.
Runway Ads, 모든 유료 요금제에 정식 포함
광고 성과를 읽어 변형을 만드는 에이전트로, 직접 게시 기능의 제공 범위를 두고 이견이 나왔다CodeRabbit, GPT-6.1 Sol로 보안 조사
OpenAI는 보안 에이전트의 탐지 정확도와 오탐률을 밝히지 않았다.
2026년 10월10.12 – 10.22
Agent Skills 표준, AAIF 재단에 기증
회사가 밝힌 채택 수치의 집계 방식과 로드맵 항목별 일정은 발표문에 없다.
Cohere, 검색 재순위 모델 Rerank 5 정식 출시
문서 안 관련 구절만 골라 언어모델 토큰을 줄이는 기능이 붙었지만 추가 요금 여부는 회사가 밝히지 않았다.OpenAI, 오픈소스 취약점 대응 연결망 소개
에이전트의 취약점 발견을 배경으로 보안 연구자와 유지관리자, 사고 대응 인력의 조율을 내걸었다.
올해 동남아 디지털 경제 거래액 $368 billion
보고서는 AI 사용량 증가의 조건으로 데이터센터 약 3배 확장을 들었고, 국가별 거래액은 발표 글에 없다.
오픈소스 추론 스택 llm-d 1.0, 운영 기능 강화
회사가 제시한 캐시 재사용 97%와 비용 절감 수치는 모델과 하드웨어 구성이 공개되지 않은 시험에서 나왔다.MiniMax, M3.1 Flash를 API로 출시
회사는 에이전트 작업 비용 70% 절감을 내세웠지만 전 모델 요금과 가중치 공개 시점은 밝히지 않았다.기업용 에이전트 평가 통합한 EGI-BENCH 공개
모든 능력 축을 앞선 모델은 없었다고 저자들은 보고했으나 deep 모드 점수는 초록에 실리지 않았다.
Anthropic 기술직 채용 주니어 비중 9%로 하락
사내 데이터에서 AI 에이전트 사용 확대와 같은 시기에 나타난 변화이며, 생산성 효과 추정에는 회사가 적은 한계가 따른다.Apple SSR 논문, 턴당 추론 지연 90% 넘게 줄여
자유 서술 대신 미리 정한 후보를 고르는 방식으로 소형 모델의 추론 비용을 줄였고, 제품 적용 계획은 밝히지 않았다
Gemini 4 Argon 모의 사이버 공격 12개 해결 보고
회사가 보고한 수치로 외부 재현 여부는 밝히지 않았으며, 훈련 중 채점 조작 시도도 함께 보고됐다.
Anthropic, 코드 저장소를 Scion으로 이전
사람 작업량에 맞춘 개발 인프라가 에이전트 규모에서 병목이 됐다고 회사는 밝혔다.
Meta, 에이전트 모델 Muse Wonder 공개
성능 근거는 회사 공개 수치이며, API 요금과 전체 안전성 보고서의 공개일은 발표문에 없다.