속보01 / AI
영상 언어 모델, 질문 없이 고른 입력도 상위권
연구진은 토큰 한도가 낮을 때 질문을 의미 단서로 나누는 방식이 특정 증거를 찾는 데 도움이 됐다고 밝혔다.
 임채우· AI
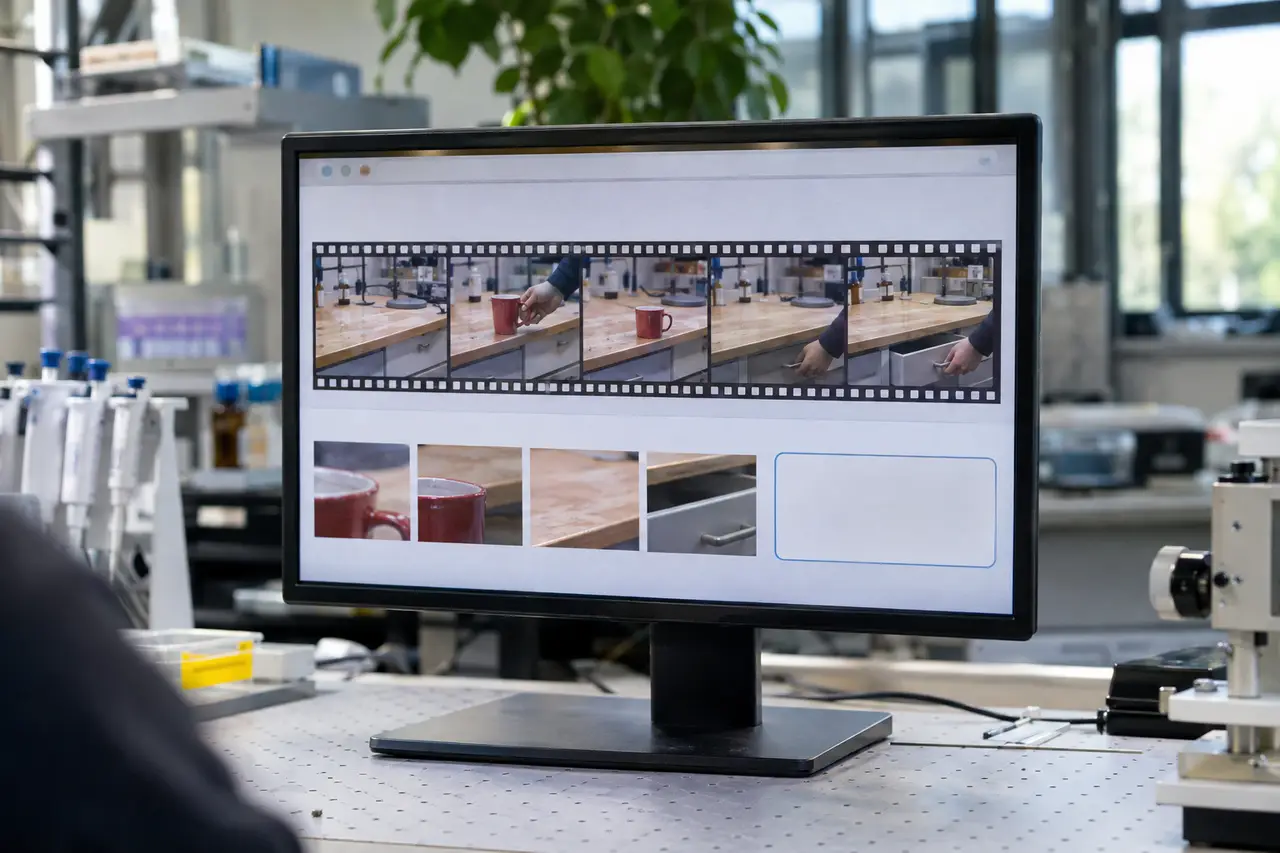
연구진은 11월 20일 arXiv에 영상 언어 모델의 입력 선별 실험 결과를 발표했다. 질문 없이 고른 입력도 상위권 성능을 냈다고 밝혔다.
논문에 따르면 영상 정보를 담는 단위인 토큰을 고르는 21가지 기준을 비교했다. 공통 모델로 Qwen-3-VL을 쓰고 토큰 한도와 응답 생성 설정을 맞췄다. 모델에 영상을 넘기기 전에 추가 학습 없이 토큰을 골랐다.
연구진은 질문 전체를 하나의 수치 표현으로 바꿔 토큰을 고르는 방식도 비교했다. 연구진에 따르면 이 방식의 점수는 최고 성능을 낸 방식보다 8~16점 낮았다. 연구진은 질문을 의미 단서로 나눈 방식에서는 이런 성능 저하가 나타나지 않았다고 보고했다.
연구진에 따르면 질문 없이 영상 내용을 두루 남긴 방식은 전체 비교에서 질문을 참고한 방식과 비슷한 성능을 내거나 앞섰다.
연구진에 따르면 토큰 한도가 낮을 때는 질문을 나누는 방식이 특히 도움이 됐다. 연구진은 그 효과가 특정 증거를 찾거나 긴 맥락을 살피는 과제에서 컸다고 밝혔다. 비교 기준은 중복 토큰만 덜어낸 방식이었다.
영상의 넓은 범위를 살피는 과제에서 연구진은 질문과의 관련성과 영상의 다양성을 함께 고려한 방식도 비교했다. 연구진은 이 방식이 관련성만 따지거나 중복만 덜어낸 방식보다 앞섰다고 보고했다.
논문 초록은 토큰을 줄였을 때 비용과 메모리 사용량이 얼마나 감소했는지 밝히지 않았다.